フレームバッファ
フレームバッファは1まとまりのメモリで、ディスプレイに次に表示する画像を格納するためにグラフィック・エンジンによって更新されます。
フレームバッファは、所定のサイズの連続したRAMの領域です。

フレームバッファ・メモリ
フレームバッファには関連付けられた幅と高さがあります。このため、通常フレームバッファは、XY座標によってインデックス付け可能な2次元でアクセスするメモリであると考えられます。

2Dのフレームバッファ・メモリ
フレームバッファには関連付けられたカラーフォーマットがあります。フレームバッファの各エントリは、このカラーフォーマットの色になります。フレームバッファ内のこうしたエントリのことを、ピクセルと呼びます。
フレームバッファ内の(X、Y)位置のピクセルの色を更新するには、フレームバッファ内のピクセルのメモリ・アドレスを計算し、そこに保存されている色を更新します。
uint32_t pixelAddress = x + y * WIDTH;
framebuffer[ pixelAddress ] = newColor;
同様に、フレームバッファ内のピクセルの色を取得し、これを計算で使用できます。たとえば、フレームバッファ内のピクセルの色を暗くする場合は、次のようになります(darken関数が使用可能だとします)。
uint32_t pixelAddress = x + y * WIDTH;
framebuffer[ pixelAddress ] = darken( framebuffer[ pixelAddress ] );
多くの場合、フレームバッファ・メモリは、上記のようにピクセルごとに読み書きされるのではなく、基盤となるシステムのハードウェア機能(Chrom-ART DMAなど)を利用することで書き込まれます。
色
TouchGFXでは、フレームバッファのピクセルのカラーフォーマットは次のいずれかになります。
- グレースケール: 1、2、または4 bppのグレースケール
- ハイカラーまたはトゥルーカラー: 16、24、または32 bppカラー
使用するbppの値が大きいほど、フレームバッファで表すことのできる色が明瞭になります。さらに、使用するbppの値が大きいほど、フレームバッファに必要なメモリサイズも大きくなります。
ディスプレイ
フレームバッファのコンテンツは最終的には物理ディスプレイに転送され、そこで表示されます。このため、通常はフレームバッファとディスプレイのピクセルの幅と高さは同じにします。

24 bppフレームバッファのコンテンツとディスプレイ結果
Further reading
フレームバッファの場所
マイクロコントローラ・ベースのグラフィック・システムを非常に簡略化した図を、次に示します。

グラフィック・システムを非常に簡略化した図
フレームバッファはマイクロコントローラ内部、または外部RAMに配置できます。

フレームバッファを配置可能な場所
配置可能な場所それぞれに、利点と欠点があります。
内部RAM
フレームバッファをマイクロコントローラ内部のRAMに配置すると、フレームバッファの読み書きアクセスが最大限に高速化されます。つまり、TouchGFXアプリケーションが可能な限りスムーズに実行されます。その反面、内部RAMは非常に少量のリソースで、システムの多くの部分によって使用されるため、フレームバッファがこの大部分を占有することは現実的ではないと考えられます。
フレームバッファを内部RAMに配置するとことが可能であれば、追加のRAMが必要なくなるので、システム全体のコストを削減することができます。
外部RAM
システムに外部RAMがある場合、フレームバッファを内部RAMの代わりにこの外部RAMに配置できます。一般的に、外部RAMに対する読み書きアクセスは内部RAMより低速ですが、外部RAMの容量の方が通常は非常に大きくなります。このため、場合によってはこれが唯一の解決策になります。
マイクロコントローラには、外部RAMへのアクセスを高速化させる機能(キャッシュなど)が備わっていることがあります。詳細については、「マイクロコントローラ」のセクションを参照してください。
GRAM搭載ディスプレイ
システム内のディスプレイのタイプによっては、ディスプレイにメモリが内蔵されていることもあります(多くはGRAMと呼ばれます)。このメモリには、ディスプレイの「物理的な」ピクセルの内容が保持されます。ディスプレイにこのピクセル・メモリがあると、マイクロコントローラがアイドル状態でもディスプレイが動作を続けることができます。
TouchGFXのフレームバッファをディスプレイ内のRAMに配置することは不可能です。ディスプレイのメモリはメモリ・マップドではなく、ランダムなピクセルの読み書きに適するようにできていないからです。代わりに、TouchGFXはフレームバッファを内部または外部RAMに配置し、これを適切なタイミングでディスプレイのRAMに転送します。
メモリ使用量
フレームバッファの色の量やピクセル数によって、フレームバッファが必要とするメモリサイズが決まります。
一般的に、フレームバッファで使用されるメモリの量は、幅x高さx色深度(ビット)/ 8 バイトになります。
| 解像度(ピクセル) | 色(bpp) | 計算 | メモリ使用量(バイト) |
|---|---|---|---|
| 800x480 | 16 bpp | 800 x 480 x 16 / 8 | 768,000 B |
| 480x272 | 24 bpp | 480 x 272 x 24 / 8 | 391,680 B |
| 100x100 | 8 bpp | 100 x 100 x 8 / 8 | 10,000 B |
複数のフレームバッファを持つと、それに応じてメモリ使用量も大きくなります。たとえば、2つのフレームバッファを使用するダブル・バッファリング方式では、メモリ使用量は2倍になります。
1つ未満のフレームバッファを持つ場合、アプリケーションによってメモリの量が明示的に割り当てられ、制御されます。このためメモリ使用量は完全にカスタマイズ可能になりますが、使用量が少なすぎるとグラフィックス全体のパフォーマンスに悪影響を及ぼすので注意してください。
フレームバッファ戦略
フレームバッファ戦略はグラフィック実装における重要なポイントであり、TouchGFXのレンダリングと既存のハードウェア(マイクロコントローラ、RAM、ディスプレイ)との間の最適なマッチングを可能にします。新しいハードウェアを選択する場合には、自分の使用例に関連する使用可能なフレームバッファ戦略をよく理解しておくことを推奨します。適切な選択を行うことはハードウェア・コストの最適化に役立ちます。つまり、フレームバッファのRAMのサイズや適切なディスプレイ・インタフェースの観点から最小限必要なハードウェアを選択するための手助けになります。
フレームバッファ戦略ではフレームバッファに使用されるRAMのサイズを定義し、TouchGFXによるRAMへのレンダリングを制御します。この戦略は、システムの使用可能なRAMやディスプレイのタイプと一致する必要があります。 TouchGFX offers four different strategies, applicable on display systems with and without GRAM. 以下の戦略の概要では、ディスプレイ・システムとの関連で各戦略の利点と欠点を示しています。
The first two tables below shows which strategies are relevant for displays with and without GRAM.
The third table has more details.
GRAMを搭載しないディスプレイ
| 戦略 | 利点 | 欠点 | 使用例 |
|---|---|---|---|
| ダブル | No risk of tearing. Optimal time for rendering | 2つのフレームバッファ用のRAM | 高パフォーマンスのUI |
| Hybrid Double | Optimal access to external RAM | Uses more RAM than double buffering | High performance UIs on large resolutions |
| シングル | 1つのフレームバッファ用のRAMのみ | ティアリングのリスクがあり、次善のレンダリング時間 | 高から中程度のパフォーマンスのUI |
| パーシャル | 1つ未満のフレームバッファ用のRAMのみ | ティアリングの高いリスクとCPUの高い負荷 | 中程度から低パフォーマンスのUI |
GRAM搭載ディスプレイ
| 戦略 | 利点 | 欠点 | 使用例 |
|---|---|---|---|
| ダブル | No risk of tearing. Optimal time for rendering | 2つのフレームバッファ用のRAM | 高パフォーマンスのUI |
| Hybrid Double | Optimal access to external RAM | Uses more RAM than double buffering | High performance UIs on large resolutions |
| シングル | Only RAM for 1 framebuffer. No risk of tearing | 次善のレンダリング時間 | 高から中程度のパフォーマンスのUI |
| パーシャル | 1つ未満のフレームバッファ用のRAMのみ | ティアリングのリスク | 中程度から低パフォーマンスのUI |
Detailed comparison.
| Comparison | Partial FB | Emulated FB | Single framebuffer | Hybrid Double framebuffer | Double framebuffer |
|---|---|---|---|---|---|
| HW Requirements | GRAM in the display; SPI or parallel 8080/6800 interface | LTDC + Chrom-GRC (GFXMMU) | N/A | MCU with 2D DMA for block copies | N/A |
| SPI (with GRAM) | Yes | No | Yes | Yes | Yes |
| QSPI (with GRAM) | Yes | No | Yes | Yes | Yes |
| Parallel 8080/6800 (with GRAM) | Yes | No | Yes | Yes | Yes |
| MIPI-DSI command mode (with GRAM) | Yes | No | Yes | Yes | Yes |
| QSPI (without GRAM) | No | Yes | Yes | Yes | Yes |
| RGB-TFT | No | Yes | Yes | Yes | Yes |
| MIPI-DSI video mode | No | Yes | Yes | Yes | Yes |
| Relative memory need (SRAM) | Smallest (~10% of a single framebuffer) | 25% of a single framebuffer | 1 full framebuffer (H x W x Bpp) | 2 full framebuffers plus internal rendering blocks | Largest: 2x full framebuffers |
| Framebuffer size (320x240, 16bpp) | 15KB | ~25KB | 150KB | 300KB + rendering blocks | 300KB |
| Framebuffer size (800x480, 16bpp) | N/A | ~115KB | 750KB | 1.5MB + rendering blocks | 1.5MB |
| Relative performance potential | Low | Low | Medium | High with external RAM | High |
| Performance overhead | Limited by smaller block updates and possible SPI interface transfer rate | Limited by repeated redrawing and display updates | Limited display update and render time | Copies rendered blocks to framebuffers using DMA | N/A |
| Minimum render time to avoid tearing | Depends on display interface | 16ms; 4ms per quarter | 16-32ms | N/A | N/A |
| Tearing risk | Low to high (low on static UIs); tearing less visible | High; complex UI development, tearing highly visible | Medium; animations limited by render time | Low; FPS drop with long render times | Low; FPS drop with long render times |
| UI implementation complexity | Medium-high | High | Medium | Medium; requires DMA configuration | Low |
| Framebuffer placement | Internal SRAM | Internal SRAM | Internal or external RAM | Framebuffers in internal or external RAM; rendering blocks in internal RAM | Internal or external RAM |
| MCU load impact | Low | High | Low | Low | Low |
| Standard use case | Normally smaller displays with GRAM. Entry-level graphics for MCUs without graphics accelerators. | Normally larger resolution displays, decreasing RAM need. "Framebuffer" placed in SRAM. Only used when RAM for a full framebuffer is not available. | Normally medium-sized display with a static UI. Can be placed internally or externally. Move to double if FPS is too low. | For large displays with external RAM, reducing external memory access overhead. | For medium to large displays without GRAM. Enables more animations and full-screen transitions. |
ティアリング
ティアリングとは、1つのスクリーン描画に2つのフレームのピクセル・データが表示されているディスプレイ上の視覚的な乱れのことです。たとえば、スクリーンの半分に古いフレーム、もう半分に現在のフレームがあり、明確な横分割(裂け目)が表示されているような状態です。裂け目(ティアリング)の位置はタイミングに応じて異なり、通常はあちこちにジャンプするので気が散って操作の邪魔になります。
UIのパフォーマンス
一般的なパフォーマンスの記事では、UIのパフォーマンスの各側面が紹介されており、個々のUIコンポーネントとその構造のパフォーマンスへの影響が取り上げられています。フレームバッファ戦略の文脈では、以下のように考えます。
- 高パフォーマンスとは、複数の複雑なUIコンポーネント/アニメーション(テクスチャ・マッパー、SVG、スクリーン遷移など)を使用するUIのことです。
- 中程度のパフォーマンスとは、少数の複雑なUIコンポーネント/アニメーションを使用するUIのことです。
- 低パフォーマンスとは、複雑なUIコンポーネント/アニメーションを使用しないUIのことです。
Note
用語
以下の用語は、さまざまなフレームバッファ戦略を説明するために使用されています。
- ディスプレイ・コントローラ(DC) - メモリからピクセルを読み出すハードウェア。 The display controller is continuously reading the memory containing pixels. The line currently being read is sometimes referred to as the scanline.
- Display Transfer (DT) - The hardware responsible of transferring pixels from framebuffer memory to GRAM (e.g. DMA with SPI or FMC). The transfer is only initiated by the MCU when required. The line currently being transferred is sometimes referred to as the transferline.
- フレームバッファへの書き込み(W) - フレームバッファへのピクセルのレンダリング。
GRAMを搭載しないディスプレイ
以下に示すのは、GRAMを搭載しないディスプレイ上のフレームバッファ戦略の実施コンセプトです。すべての戦略に共通するのは、ディスプレイ・コントローラを使用して、フレームバッファから直接ピクセル・データを絶え間なく読み出し続けることです。
ダブル・バッファリング戦略
2つのフレームバッファを持つことで、次のフレームを1つのフレームバッファ内にレンダリングする間に、ディスプレイ・コントローラがもう一方のフレームバッファをスキャンできます。次のフレームのレンダリング時間はディスプレイ・コントローラによる制限を受けません。フレームバッファのスワッピングは次のフレームの準備ができるまでブロックされます。つまり、ディスプレイ・コントローラは準備ができるまで現在のフレームバッファをもう一度スキャンするので、ティアリングのリスクがありません。フレームバッファのスワッピングは、ディスプレイ・コントローラがフレームバッファ全体のスキャンを完了し、レンダリングが完了した後に行われます。

ダブル・バッファリング戦略のコンセプト
Hybrid Double Buffering Strategy
The hybrid double buffer strategy extends the double buffer strategy. It uses two full framebuffers and a few smaller buffers in internal RAM. As with the double buffer strategy the first framebuffer is free for rendering while the display controller is reading the second framebuffer.
All rendering is performed in small steps into the small buffers. When rendering of a block is complete, the block is copied to the external framebuffer using a DMA operation.
When a block has been copied to the external framebuffer, it will be reused for more rendering.
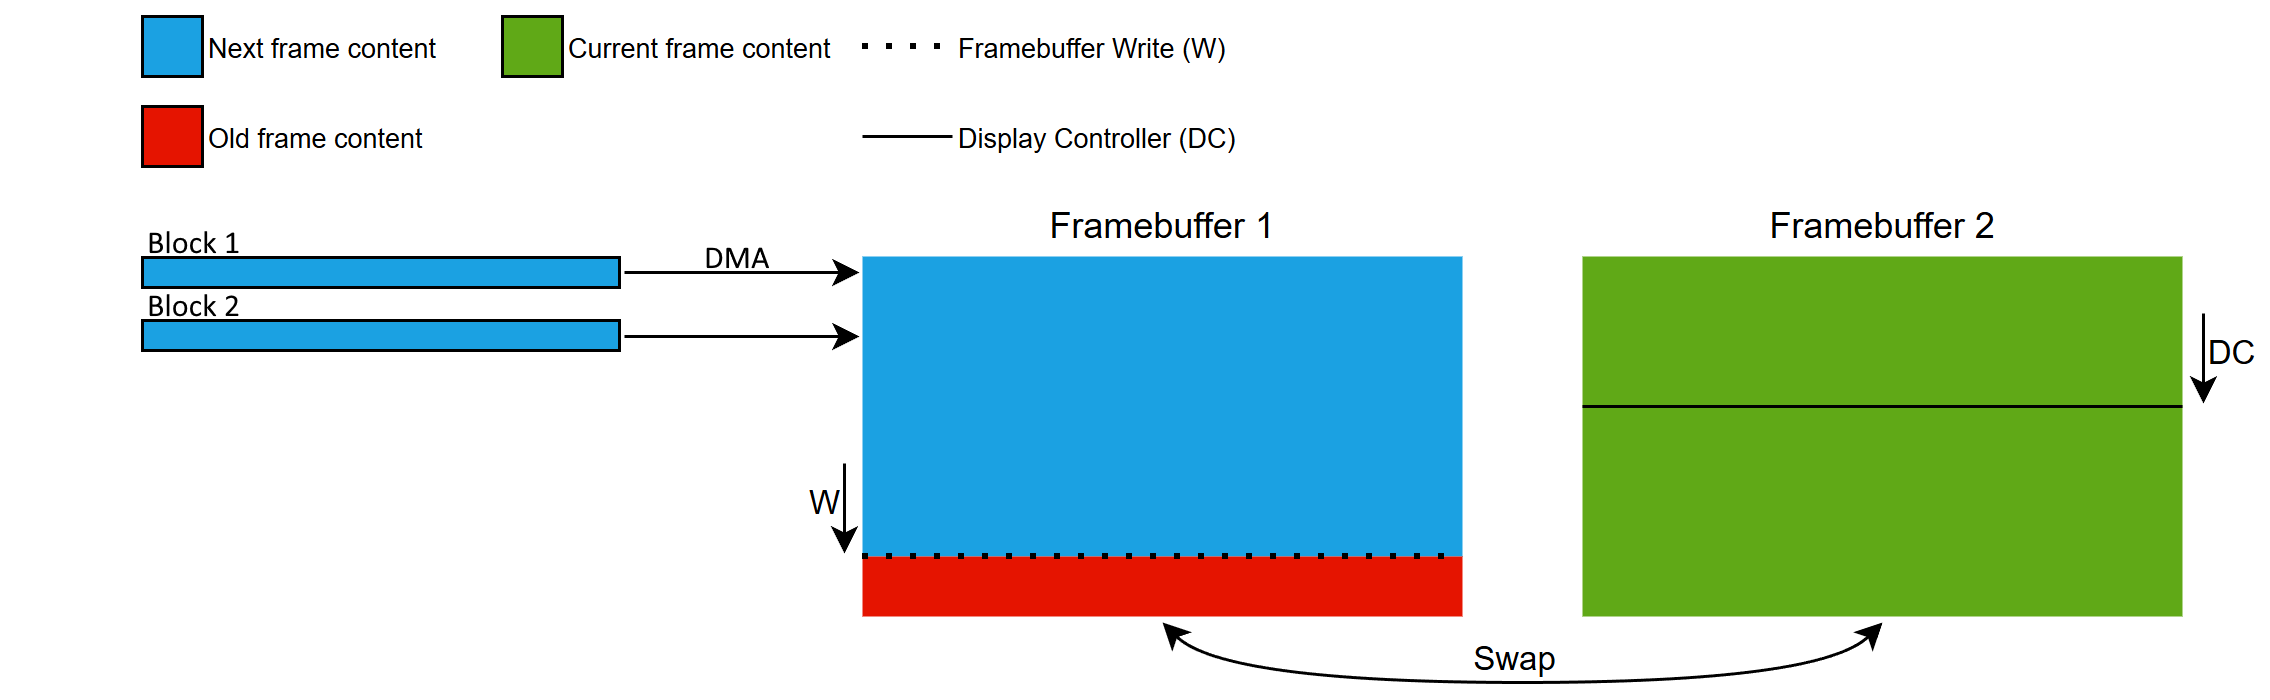
Hybrid Double Buffering Strategy Concept
There are two benefits to this strategy: Performance and external RAM access patterns.
Performance can be better because it is faster to read and write the internal RAM than external RAM. But the gain of using internal RAM must cover the extra cost of copying the block to external framebuffer.
The following examples compare the memory operations required by the hybrid and double buffer strategies:
| Rendering operation | Double Buffering | Hybrid Double Buffering |
|---|---|---|
| Render a single color | One write to external RAM | Write to internal RAM, then one DMA write to external RAM |
| Render a color and blend another color over it | Write color 1, then read, blend, and write the result twice in external RAM: 1 read + 2 writes | Read and write in internal RAM, then one DMA write to external RAM |
Depending on the relative performance of the external RAM versus the internal RAM, the hybrid strategy can improve performance.
The second benefit comes from always using a DMA for writing to the external framebuffers. When copying the completed blocks the DMA will issue burst writes to the external RAM when possible. This reduces the contention on the memory bus.
The result is that more bandwidth is available for the LTDC and lowers the likelyhood of LTDC underrun errors.
A given system may therefore be able to run a more advanced UI or use a larger resolution using the hybrid double buffer strategy.
Note
シングル・バッファリング戦略
フレームバッファが1つなので、ディスプレイ・コントローラがフレームバッファからスキャンしながら、次のフレームを同じフレームバッファ内にレンダリングします。次のフレームのレンダリング時間はディスプレイ・コントローラによる制限を受けます。ディスプレイ・コントローラはスキャンを続けているので、フレームバッファへの書き込みに時間がかかりすぎると、ディスプレイ・コントローラが書き込み領域にぶつかり(追いついて)、ティアリングが発生します。この状況は複雑なUIコンポーネントのレンダリングが原因で起こります。

シングル・バッファリング戦略のコンセプト
パーシャル・バッファリング戦略
メモリ管理ユニット(MMU)を介して、1つのパーシャル・フレームバッファ・ブロックを使用してフル・サイズのフレームバッファをエミュレートします。したがって、この戦略はエミュレートされたフレームバッファ戦略とも呼ばれます。
パーシャル・ブロックがスライディング・ウィンドウの役割を果たし、エミュレートされたフレームバッファを介して、ディスプレイ・コントローラのフェーズと速度で下へ移動します。
パーシャル・フレームバッファ・ブロックでは、次のフレームのごく一部のみをレンダリングします。このブロックを何度も再利用して現在のフレームをレンダリングすることになります。パーシャル・ブロックの再利用によって多数の小さなレンダリング操作が発生するため、CPU負荷が高まります。次のフレームのレンダリング時間は、ディスプレイ・コントローラとパーシャル・ブロックのサイズによる制限を受けます。ディスプレイ・コントローラはスキャンを続けているので、エミュレートされたフレームバッファの特定の領域でパーシャル・フレームバッファ・ブロックへの書き込みに時間がかかりすぎると、ディスプレイ・コントローラが書き込み領域にぶつかり(追いついて)、ティアリングが発生します。この状況は複雑なUIコンポーネントのレンダリングが原因で起こります。シングル・バッファリンング戦略と比べて、ティアリングのリスクは高まります。ディスプレイ・コントローラとフレームバッファ・レンダリングのワーク領域がはるかに小さいからです。

パーシャル・バッファリング戦略のコンセプト
GRAM搭載ディスプレイ
以下に示すのは、GRAM搭載ディスプレイ上のフレームバッファ戦略の実施コンセプトです。すべての戦略に共通するのは、ディスプレイ・インタフェースを使用して、フレームバッファからディスプレイのGRAMにピクセル・データを転送することです。
ダブル・バッファリング戦略
2つのフレームバッファを持つことで、ピクセルを1つのフレームバッファからGRAMへ転送しながら、もう一方のフレームバッファに次のフレームをレンダリングすることができます。次のフレームのレンダリング時間はディスプレイ転送による制限を受けません。ディスプレイへの転送は次のフレームの準備ができた場合にのみ開始されます。つまり、ディスプレイ・コントローラはGRAM内にすでに存在するデータのみをスキャンするので、ティアリングのリスクがありません。フレームバッファのスワッピングは、ディスプレイへの転送とレンダリングが完了した後に行われます。

ダブル・バッファリング戦略のコンセプト
Hybrid Double Buffering Strategy
The hybrid double buffering strategy also works with displays with GRAM.
It interacts with the display as the double buffering strategy. The only difference is how the framebuffer is updated. See the description the hybrid double buffering strategy above.
シングル・バッファリング戦略
フレームバッファが1つですので、ピクセルがGRAMに転送されている同じフレームバッファ内に、次のフレームをレンダリングすることになります。次のフレームのレンダリング時間はディスプレイ転送の帯域幅による制限を受けます。ディスプレイへの転送は次のフレームの準備ができた場合にのみ開始されます。つまり、ディスプレイ・コントローラはGRAM内にすでに存在するデータのみをスキャンするので、ティアリングのリスクがありません。次のフレームのレンダリングは、更新に該当するエリアがGRAMに転送されるまで完了できません。

シングル・バッファリング戦略のコンセプト
パーシャル・バッファリング戦略
1つ以上のパーシャル・フレームバッファ・ブロックを使用して、フル・サイズのフレームバッファをエミュレートします。
パーシャル・ブロックを再利用して、現在のフレームで更新の必要なすべての部分をレンダリングします。 1つのブロックがレンダリングされたらそれをGRAMに転送して、後続のレンダリングに使用できます。
ティアリングのリスクを最小限に抑えるため、ディスプレイ転送によって更新されるGRAMとディスプレイ・コントローラのスキャンラインの間に最大限のマージンをとるように努めています。このため、スキャンラインの背後に転送ラインを設けているので、現在のフレームのみがレンダリング可能で、次のフレームのレンダリングは開始できません。現在のフレームのレンダリング時間は、定義されたパーシャル・ブロックの数と各ブロックの転送にかかる時間によって異なります。つまり、1つのブロックが使用可能な場合、ディスプレイ・コントローラのスキャンラインの前にあるブロックのレンダリングが可能となります。現在のフレームのすべてのダーティ・エリアのレンダリングと転送に、ディスプレイ・コントローラより長い時間がかかっている場合、スキャンラインのラップ・アラウンドが発生し、転送ラインに追いついてしまい、ティアリングが発生します。この状況は複雑なUIコンポーネントのレンダリングや、過剰な数のピクセル転送が原因で起こります。

パーシャル・バッファリング戦略のコンセプト
フレームバッファ戦略入門
次のセクションでは、一般的なハードウェアのセットアップを示し、さまざまなハードウェア・セットアップでフレームバッファ戦略を使用するシナリオを提示します。
Further reading
GRAM搭載ディスプレイ
このディスプレイ・タイプには、ディスプレイと同じサイズの専用のRAMバッファ(フルサイズのフレームバッファ)が搭載されています。

GRAM搭載ディスプレイ
このタイプのディスプレイのインタフェースは以下のとおりです。
- FMC
- SPI
- DSI(コマンドモード)
これらのインタフェースの使用をデモンストレーションするシナリオには、以下のリンクからアクセスできます。
GRAMを搭載しないディスプレイ
このディスプレイ・タイプは専用のRAMバッファを搭載していません。

GRAMを搭載しないディスプレイ
このタイプのディスプレイのインタフェースは以下のとおりです。
- LTDC
- DSI(ビデオ・モード)
これらのインタフェースの使用をデモンストレーションするシナリオには、以下のリンクからアクセスできます。